硅谷科技巨头,又盯上了一个新的AI入口。
10月21日,Anthropic推出个人智能体Claude Duet,试图让AI在用户离开电脑后继续工作,主动处理日程、文件和其他任务。此外,9月Meta放出的大招Muse技惊四座,OpenAI、Google也在加快布局,Personal Agent正快速成为新一轮AI产品竞争的焦点。
借此,AI行业开始重新审视模型的使用方式。如今,一个Agent为了完成任务,可能需要反复调用模型、操作软件、检查结果,连续工作数小时。模型单次推理成本不断下降,AI执行任务的次数和复杂度却在增加。
算力需求的增长,已经反映在科技巨头的采购动作上。
据路透社报道,字节跳动、阿里巴巴和腾讯订购了超过300万张英伟达RTX PRO 5500显卡,总价值超过350亿美元。尽管这批产品属于工作站显卡,英伟达仍无法保证全部交付。
一边是AI应用不断消耗新的算力,一边是高端芯片供应持续受限,国产GPU厂商迎来了争取这批超强付费能力客户的机会。不过,随着模型和应用更新越来越快,客户采购算力时也开始考虑更长远的问题。一批花费巨资购入的GPU,究竟能在未来几年里发挥多大价值?
英伟达让出的市场,国产GPU能接住多少?
往前数三年,客户采购GPU时最关心的是峰值算力、显存容量和单卡性能排名。
如今,这个“考点”正在悄悄变化,系统级效率、模型快速迭代下的长期适配能力,以及部署和运维的真实成本,进入了针对供应商的重点考察范围。
2026年上半年,英伟达在中国数据中心AI芯片市场的份额降至34%,华为则达到28%。
国产GPU厂商等待多年的市场机会,正在逐渐变成订单。但真正进入客户的数据中心,仍然需要跨过不少门槛。
这类项目的复杂之处,主要藏在芯片采购之后。GPU能否跑通客户使用的模型,部署需要多少工程师,后续能否稳定运行,都会影响企业最终的采购决定。
在传统行业,换用国产GPU甚至可能牵动一套运行多年的软件系统。
中国石化胜利油田物探研究院此前长期使用国外商业硬件运行勘探软件。研究院首席专家张猛接受媒体采访时提到,迁移至国产平台,需要对原有程序架构、开发语言和接口进行改造。
中科曙光高端计算总工程师卜景德也曾对媒体表示,部分科研算法的深度适配与优化,需要几十名工程师参与,复杂项目的团队规模甚至接近一两百人。
如果一家企业已经投入多年开发软件,即使国产GPU的采购价格更有吸引力,也很难忽略重新适配所付出的时间和人力成本。
如今,AI模型更新越来越快,又让计算这笔账变得更加复杂。
9月,DeepSeek发布V4.1-Flash,通过调整模型架构,将运行时所需的高带宽显存缓存压缩至上一代的四分之一,SSD存储需求降至八分之一。模型厂商不断优化计算方式,GPU厂商则需要跟进新的模型架构,才能尽可能发挥这些改进带来的效率优势。
而Personal Agent的兴起,也让AI应用对算力提出了新的要求。模型需要连续处理任务,频繁调用工具,还可能同时服务大量用户。客户既希望提高GPU利用率,也需要控制长期运行成本。
问题在于,GPU服务器通常要使用多年,模型却可能在几个月内经历多次更新。客户今天完成模型部署,未来换用新模型时,仍可能需要重新适配和调优。
尽管海外的供应限制为国产厂商打开了市场,但客户最终愿意采购多少国产GPU,还取决于后续投入,让已有设备持续适应新的AI应用。
把144颗GPU装进一个机柜
近期,国产GPU与英伟达之间的性能差距,正在出现一些值得关注的变化。
10月28日,天数智芯在上海举行的开放日活动上,新一代高端通用GPU天垓300首次对媒体开放实机演示。此前,已有第三方权威机构针对四款主流模型、三类应用场景开展测试,在典型的PD分离部署下,天垓300折算单卡的端到端推理吞吐达到英伟达H200的1.05倍。
PD分离将大模型处理输入和生成回答两个阶段交给不同计算资源,已经成为提高推理效率的重要部署方式。相比理论算力峰值,这项测试更接近客户实际运行模型时的工作负载。
在天数智芯性能实验室的测试中,天垓300运行主流模型的首字延迟较H200降低约10%至30%。训练方面,基于Qwen3-32B模型的8卡整机测试,每卡有效吞吐达到H100的1.33倍。
现场还播放了一段经过200倍加速的训练视频。两款GPU同时运行100个训练周期,天垓300率先完成任务,模型收敛曲线则与H100基本一致。
不过,随着大模型应用越来越复杂,单卡性能已经无法决定整套算力系统的效率。
天数智芯AI与加速计算负责人单天逸在演讲中提到,过去十年,行业不断增加算力投入,实际利用率却远没有跟上。按照他援引的数据,推理场景的平均算力利用率不足20%,训练场景也仅有40%出头。
他将客户需要的算力归纳为三个标准:高效率、可预期和可持续。除了在相同时间内完成更多任务,企业还希望系统性能稳定、部署结果可以预估,未来更换模型和算法时,原有设备仍能继续发挥作用。
以当前广泛采用的混合专家模型为例,一次推理任务包含多种计算环节,有的需要处理大量矩阵运算,有的对数据传输和响应延迟更加敏感。让所有任务都由同一种芯片承担,未必能够获得最优效率。
天数智芯此次重点介绍的AFD异构计算方案,尝试让天垓300与其他厂商的专用加速芯片共同完成模型推理。
其中,天垓300负责输入处理,以及生成阶段的注意力计算,合作厂商的XPU承担专家网络计算。两种芯片需要不断交换中间结果,分工带来的计算收益必须足以覆盖通信开销。
按照现场披露的测试结果,这套方案将解码阶段的推理延迟降低了60%。
大型数据中心往往已经采购了不同厂商的计算设备。新部署的国产GPU如果能够与原有芯片共同运行,客户便可以根据模型特点调整资源配置,保留已有算力资产。
不过,当参与计算的GPU从几颗增加到上百颗,数据传输又会成为新的难题。
天数智芯此前在中国国际工业博览会上展示的IXL144超节点,将144颗GPU和18颗CPU集成在一个机柜内,聚合显存约10.1TB,整柜互联的单跳时延达到100纳秒级。
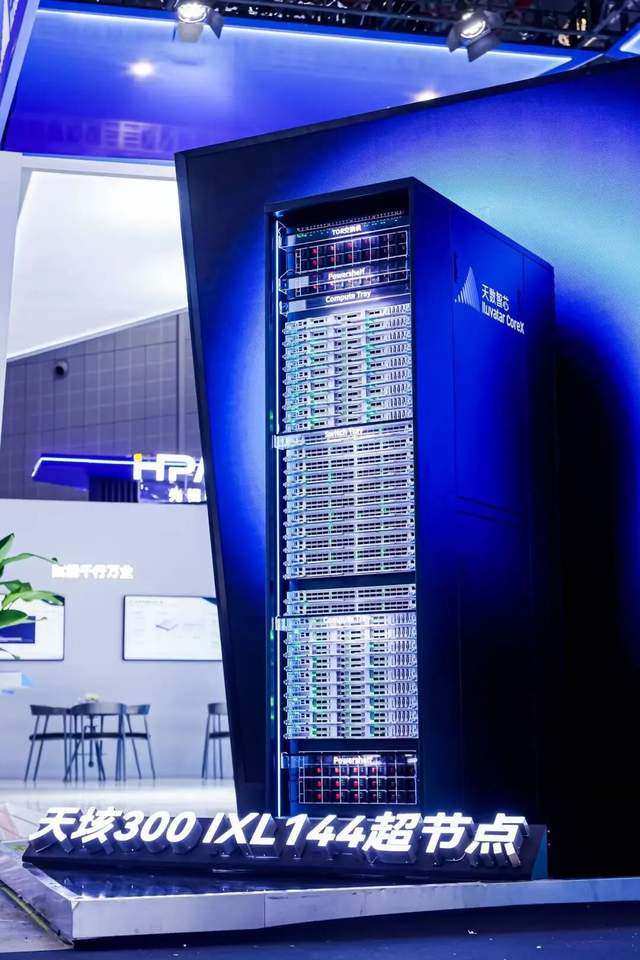
大模型运行过程中,多颗GPU需要频繁交换数据。如果通信耗时过长,即使单颗芯片性能很强,也可能有大量时间消耗在等待上。天垓300 IXL144通过高速互联,将更多计算和数据交换集中在机柜内部。
天数智芯给出了一项成本测算,相比国际主流方案,每百万有效Token的成本可降低40%。
硬件性能逐步追赶之后,软件适配仍然是国产GPU绕不开的一道门槛。
新模型发布后,工程师需要检查驱动、配置计算环境,再根据运行结果调整参数。即使模型已经能够运行,后续性能优化也可能耗费数天时间。模型更新越快,这类工作就越频繁。
天数智芯副总裁、软件开发负责人石加圣在现场尝试改变这一流程。
在一项复杂模型部署任务中,开发者只需向Agent输入目标,后者便开始调用安装和部署工具,检查软件依赖,并根据执行反馈调整操作。过去需要工程师逐项完成的配置工作,被组织成了一套可重复执行的流程。
按照目前披露的案例,从环境准备到模型正常提供服务,耗时由1小时缩短至10分钟,人工操作从数十步减少到一次目标输入。
更复杂的性能优化也被纳入其中。
Agent读取GPU的运行轨迹和关键指标,寻找拖慢模型运行的环节,再调用工具进行调整和验证。一项原本需要7天的调优工作,在案例中被压缩至2小时以内,特定工作负载的整体性能提升接近一倍。
石加圣还展示了Agent参与底层GPU程序开发的过程。生成的代码需要经过编译、正确性检查和实际性能测试,工程师仍负责重要决策和最终验收。
过去,GPU厂商积累的软件优化经验往往掌握在少数工程师手中。天数智芯尝试将这些经验整理成Agent可以调用的工具和操作规则,减少新客户部署模型时反复排查、重复开发的工作量。
现场还有一组画面,展示了通用GPU在大模型之外的用途。
一只虚拟机械臂将散落的字母方块逐一归位,拼出“ILUVATAR”。机械臂的运动、方块落地后的碰撞和摩擦,都由单张天垓300实时计算。随后,256个虚拟机械臂同时运行,每个机械臂从不同角度出发,单卡每秒完成超过20万次仿真状态推进。
机器人研发需要大量试错,虚拟环境可以让研发团队同时测试不同动作,减少真实设备反复训练的成本。
到了端侧产品展示环节,天数智芯干脆把近期爆火的MicroDuck搬到了现场。
这只复刻版的机器鸭是通过3D打印和手工组装完成,借助彤央TY1200端侧算力终端,团队在不调用云端资源的情况下完成物理仿真、策略训练和动作验证,机器鸭最终成功站立。
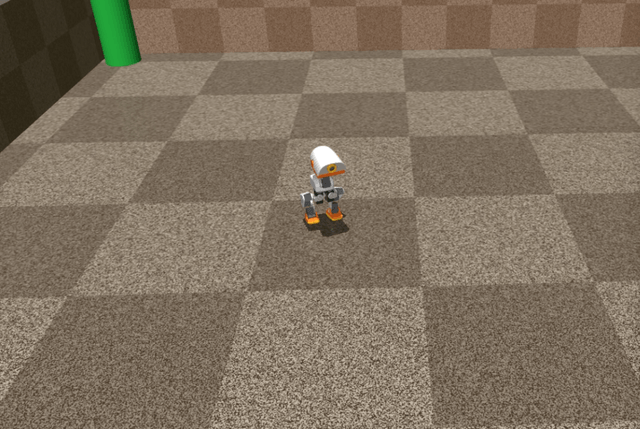
此前,类似的机器人动作学习往往需要借助云端计算资源。天数智芯将训练放进一台本地设备,利用端侧算力驱动,为AI硬件团队提供了另一种更安全、高效的选择。
拿到下一笔复购订单
四五年前设计的一款国产GPU,到了2026年,还能继续运行最新的大模型。
天数智芯副总裁宋煜在交流中提到了上述细节。公司第二代GPU虽然已经推出多年,但客户仍然可以通过软件升级,使用新发布的模型。
在模型快速迭代的当下,GPU的使用寿命正在面临新的考验。以往企业采购一批服务器,往往可以按照既定业务运行多年,内部运维的地位无可撼动。如今,模型架构和推理方式不断变化,硬件还没到淘汰周期,软件可能已经更新了好几轮。
据透露,目前天数智芯已经拥有380多家客户,覆盖30多个行业。客户应用通常可以在一小时内完成迁移,进一步的性能优化需要一周至15天。
公司每半年还会对数十家客户进行回访,目前客户满意率超过98%。宋煜还提到,客户完成首次部署后,能否及时跟进主流模型的更新,已经成为影响后续复购的重要因素。
另一批客户,则正在把GPU从数据中心搬到尺寸更小的设备里。
天数智芯彤央产品市场负责人宋远盈观察到,随着小模型能力不断提升,一些曾需要调用云端大模型完成的任务,如今可以交给本地设备处理。尤其在科研、工业等领域,客户还需要考虑数据保密、响应速度以及长期使用成本。
为了满足不同客户的需求,彤央系列提供算力模组和一体化终端两种形态。具备硬件研发能力的企业,可以将模组集成到机器人或专用设备中;希望尽快投入使用的客户,则可以选择集成CPU、GPU和存储的一体化终端,减少自行搭建计算系统的工作。
河海大学金坛校区的电池材料分析实验平台,已经部署了基于彤央TY1200的科研智能体。
此前,实验室不同仪器产生的数据分散在各自的系统里,研究人员需要花费大量时间整理、核对,再撰写分析报告。而现在,系统可以自动采集仪器数据,完成清洗、分析和报告生成,部分报告生成工作只需约两分钟。
另一层好处在于,科研数据留在本地,也方便实验室持续积累研究成果。随着实验次数增加,原本分散的数据能够统一保存和调用,减少重复整理的工作。
类似的本地算力需求也出现在文旅和公共服务领域。一家中小规模博物馆白天利用TY1200提供智能导览,夜间则使用同一台设备训练小模型,提高设备利用率。
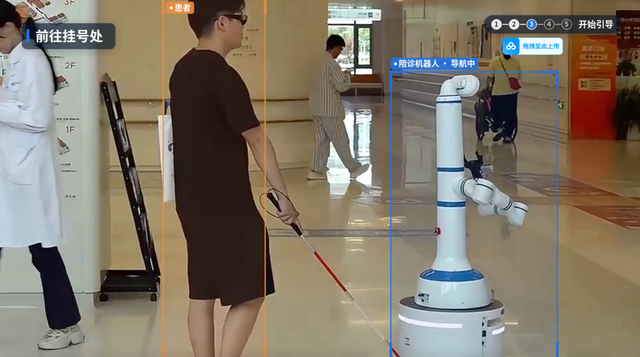
在上海市阳光康复中心,一款搭载彤央算力终端的AI导诊机器人已经投入使用,可以为视障人士提供问询和引导服务。天数智芯也正通过算力模组进入机器人市场,让客户能够在自己的产品中集成视觉识别、感知和决策能力。
从数据中心里的千卡集群,到实验室和机器人身上的小型算力终端,再到Personal Agent让AI真正开始“替人干活”,国产GPU的考题,也从单纯的性能竞赛,变成了效率、成本与长期适配的综合考核。
长程任务赋予了Personal Agent更加繁重的上下文记忆、任务规划、工具调用、多用户并发需求,客户对算力、成本、延迟的要求也在变化,开始关注GPU能否稳定支撑Agent连续工作数小时,并且在模型更新后依然高效。
芯片性能之外,部署效率、长期运行成本和软件生态,都将影响下一轮的采购选择。
单天逸由此谈到了算力系统的另一种可能:“未来的AI算力系统,不一定由一种芯片包打天下。”在他看来,“关键是如何把它们高效组织起来,让整个系统发挥更大的价值。”