作者丨林夕
编辑丨小龙
AI训练数据赛道,又诞生了一笔大额融资。
9月22日,AI数据服务商Snorkel AI宣布完成3.5亿美元E轮融资,投后估值达到35亿美元(约235亿元)。本轮由Insight Partners和S32领投,Addition、Lightspeed、Greylock、GV、Wells Fargo等机构跟投。
这距离上一轮融资仅过去17个月。
2025年5月,Snorkel完成1亿美元D轮融资,估值13亿美元。如今,公司估值已接近当时的3倍。
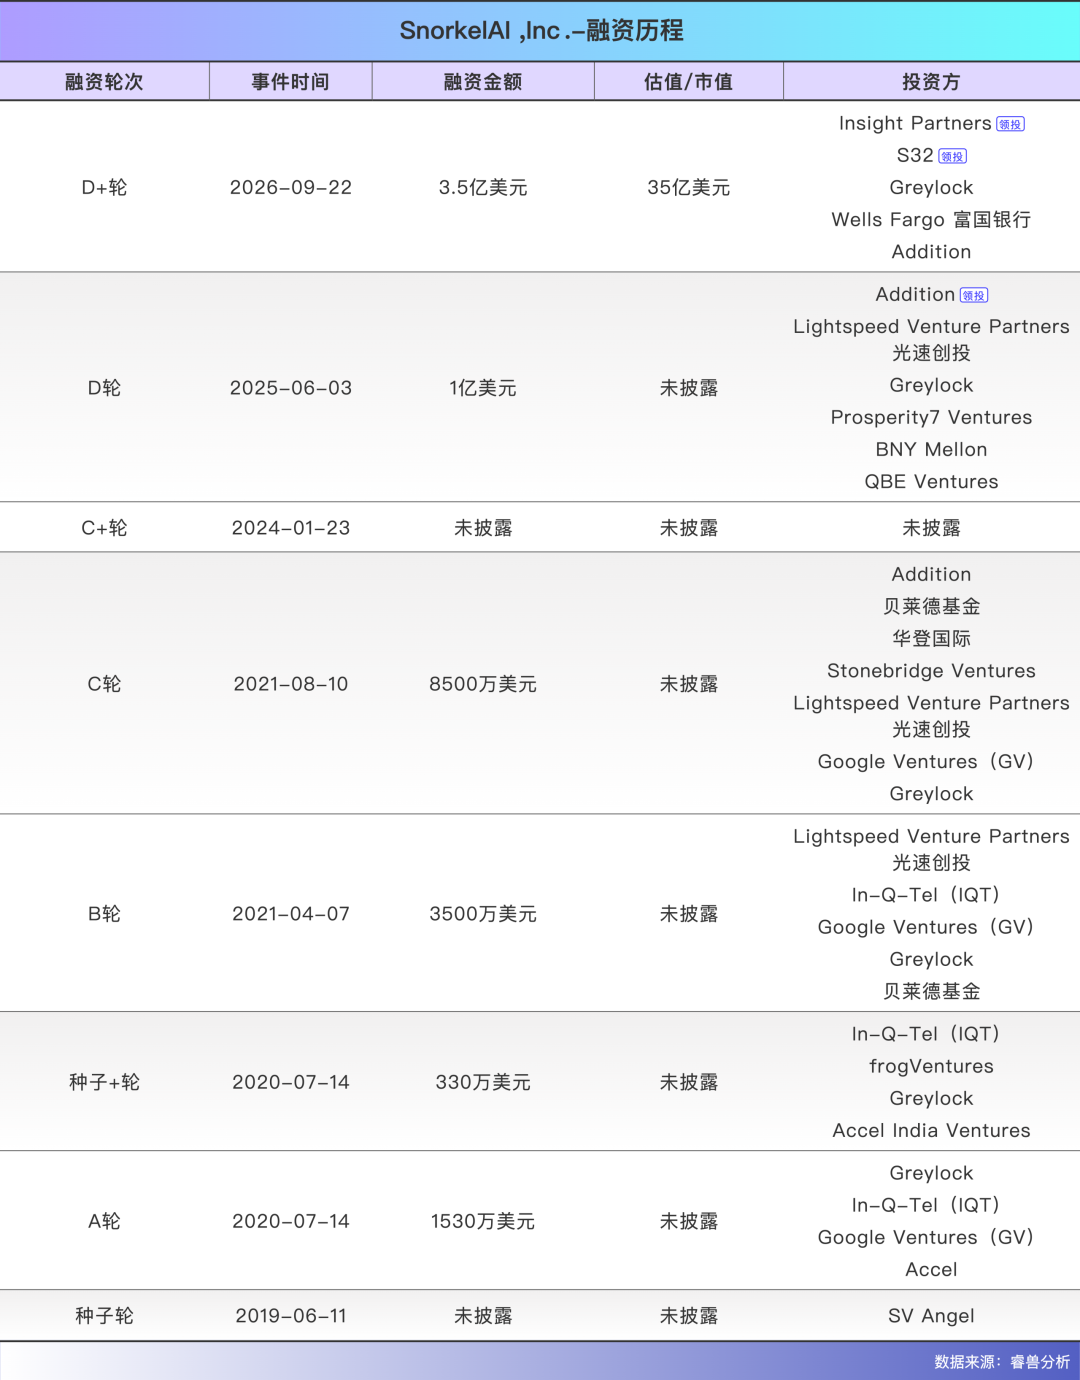
资本加速涌入的背后,是一条更陡峭的收入曲线。
Snorkel披露,目前公司年化收入已达到3.75亿美元。一年前,这个数字还只有约2000万美元,短短一年增长约18倍,公司预计今年实现盈利。
一家不训练大模型、不生产芯片的公司,为什么能获得如此高的增长?
01从斯坦福实验室出发,先做了一套“给数据打标签”的软件
Snorkel的故事,要从斯坦福AI实验室开始。
联合创始人兼CEO Alex Ratner在斯坦福攻读计算机博士期间,研究的就是机器学习中的数据问题。当时,模型训练仍高度依赖人工标注:专家需要逐条查看数据、判断类别,再将结果交给模型学习。
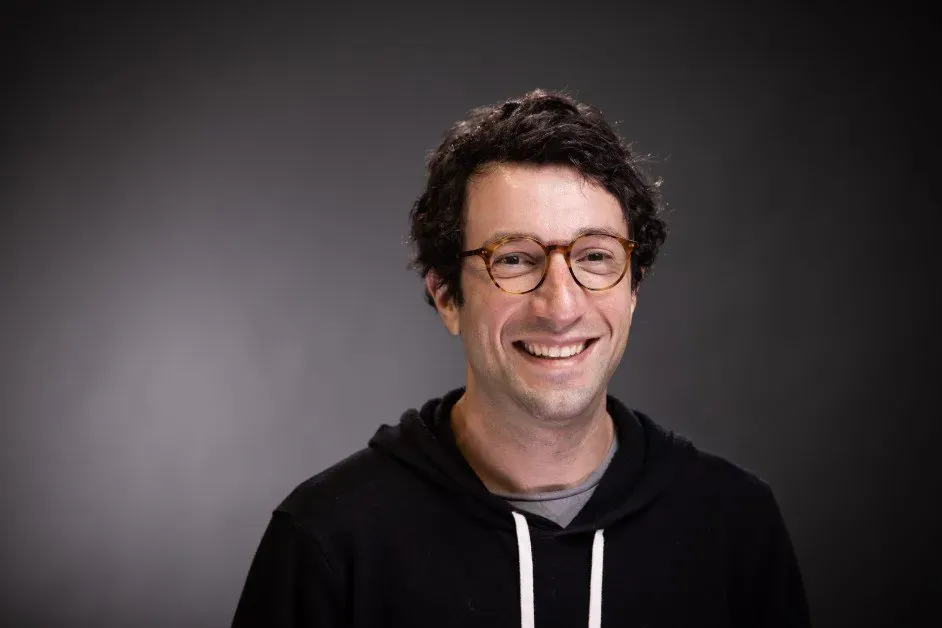
Alex Ratner
Ratner想解决的是其中最耗费人力的一环:能不能让专家不再逐条标注,而是把自己的判断规则交给机器,由程序批量处理数据?
2017年,Ratner等人在斯坦福AI实验室发表Snorkel相关论文,提出“数据编程”(Data Programming)方法。专家不再直接给每条数据贴标签,而是编写规则或标注函数,再由系统利用这些规则生成大量训练标签,并处理不同规则之间的冲突。
例如,在医学影像场景中,医生可以定义哪些特征可能对应某种疾病,系统再据此处理大规模数据。专家的作用,从重复性的标注劳动转向制定判断标准。
这套方法很快从实验室走向产业。Snorkel团队的技术曾在Google、Intel、Apple、Stanford Medicine等机构得到应用。经过数年的研究和迭代,2019年,Ratner带领团队从斯坦福AI实验室分拆,正式创业。
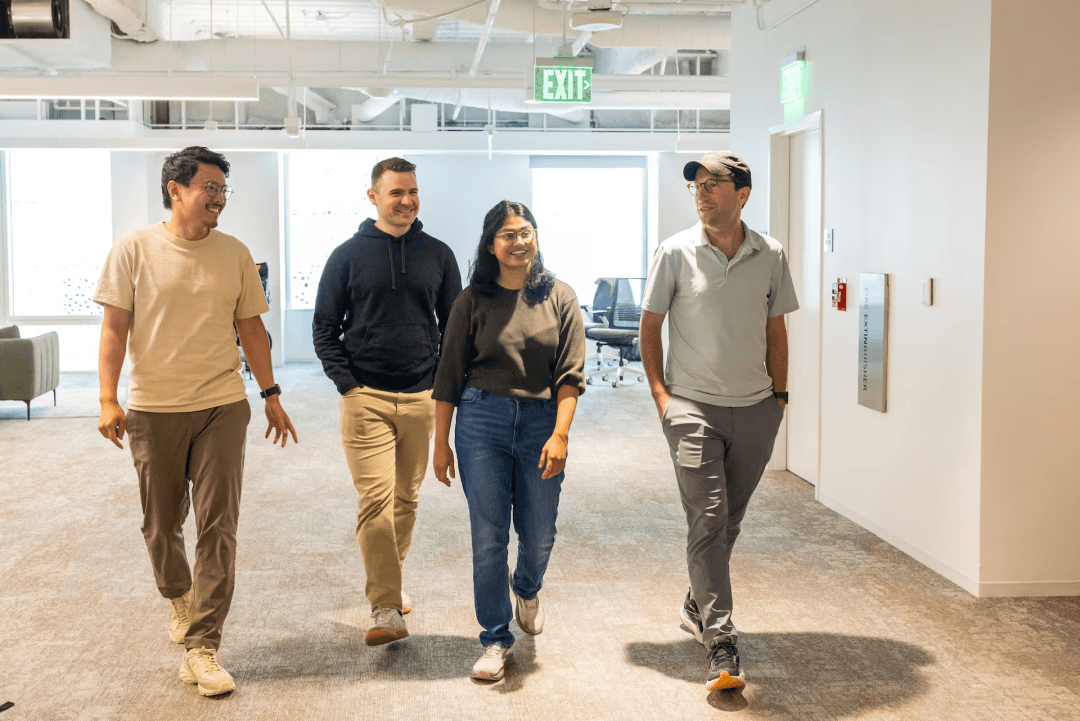
从左至右依次为:Snorkel AI公司副总裁Vincent Sunn Chen、联合创始人Henry Kiss Ehrenberg、联合创始人兼研究主管Paroma Varma以及首席执行官兼联合创始人Alex Ratner
2020年,Snorkel推出商业产品Snorkel Flow。
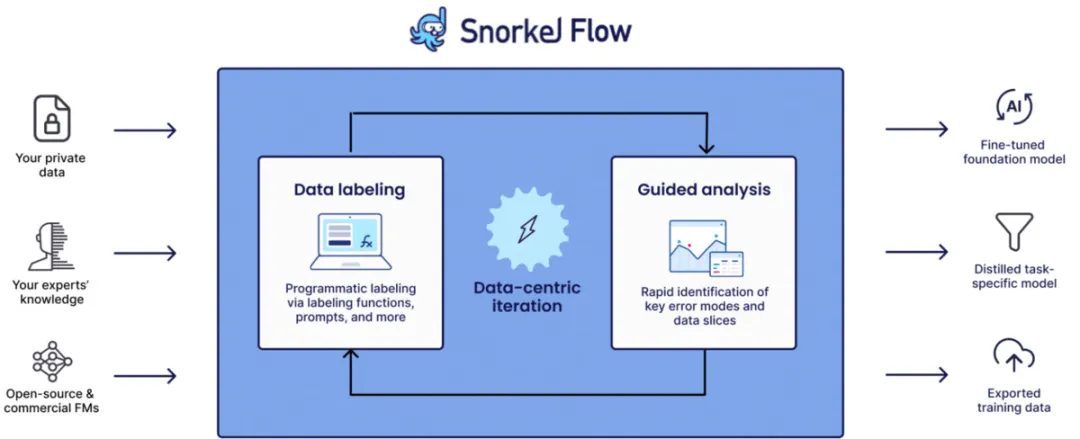
早期的Snorkel,本质上是一家数据基础设施软件公司:客户提供原始数据,领域专家通过规则定义如何标注,Snorkel Flow负责将这套流程自动化。
相比传统的人工逐条标注,这种模式可以用更少的专家处理更大规模的数据,也因此成为Snorkel早期商业化的核心。
但它的边界同样清晰:客户仍然需要自己拥有数据、设计任务,并完成整个数据生产流程。
随着大模型进入高速发展期,这一模式开始显得不够。
模型训练所需要的数据,从通用文本逐渐扩展到代码、数学、法律、医疗等专业领域。尤其在后训练阶段,模型需要的不只是“标准答案”,还需要专业人士告诉它为什么一个答案是对的、另一个答案为什么不够好。
Snorkel也由此开始从数据生产工具向模型评测和专家数据延伸。
2025年5月,公司完成1亿美元D轮融资,估值达到13亿美元。同期披露的案例显示,一家大型美国银行让贷款专家参与构建AI系统,用于回答机构客户相关问题,模型准确率从25%提升至93%;AI销售公司Rox使用Snorkel生成的评测数据后,模型准确率提升了10%至12%。
这时,Snorkel已经不再只是帮助客户“处理数据”,而是在参与定义模型应该学什么,以及如何判断模型有没有学会。
2025年9月,Snorkel开始把自己的专家网络、软件系统和AI模型结合起来,直接向客户交付成品训练数据、评测数据和强化学习环境,将业务从传统的软件授权进一步推进到Data-as-a-Service。
Snorkel由此完成了从“卖工具”到“卖数据”的转身。
02一年收入涨18倍,Snorkel卖的已经不是“标注”
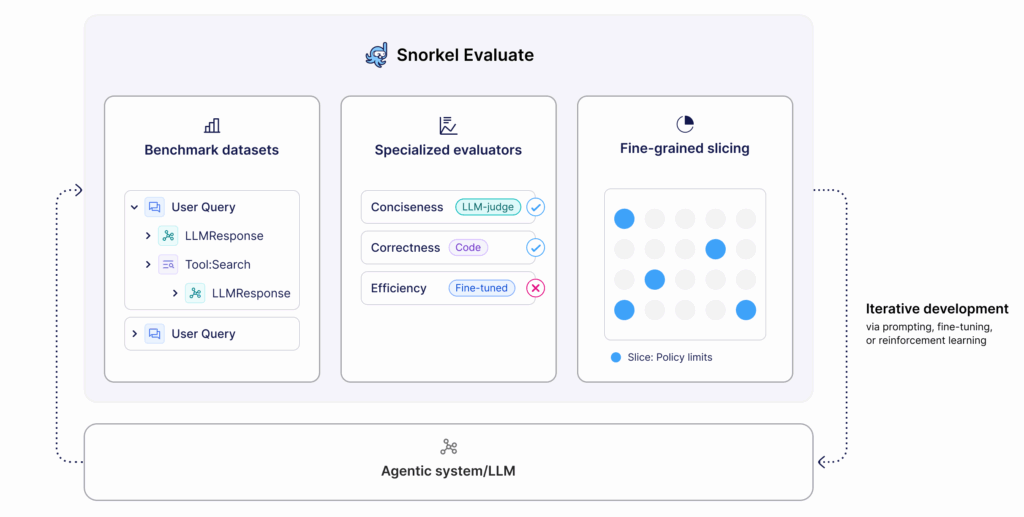
Snorkel目前拥有数万名专业人士组成的专家网络,覆盖编程、法律、医疗等领域。专家不再承担大规模、重复性的基础数据处理,而是负责定义任务、设计场景、制定评分标准,并判断什么样的结果才算正确。
剩余的大量工作交给AI完成。
Snorkel会调用不同的专用模型和AI Agent参与数据生成、检查和质量控制。今年9月,公司披露,在编程Agent的数据生产中,单个任务最多可以调用数百个专用AI模型进行交叉检查。按照公司披露的数据,这套系统使质量控制效率提升50%以上;与单纯依赖通用大模型审核相比,准确率提升超过15个百分点。
由此形成了Snorkel目前的一套数据生产方法:专家负责定义标准,AI负责按照标准规模化执行。
过去,一名程序员可能需要花费大量时间逐个判断代码任务;现在,专家更多承担任务设计、规则制定和关键结果判断,数据生成、筛选以及大部分初步质检则由AI完成。
这改变的不只是生产效率。
当专家的判断被转化为规则、任务和评价体系之后,它就不再只能用于一次数据生产,而可以持续生成新的任务和反馈,再用于训练和优化模型。Snorkel将这一过程称为数据开发的“递归自我改进”循环:AI帮助专家提高数据生产效率,专家产生的反馈又被用于改进AI系统。
这也是公司收入快速增长的一个重要背景。
过去一年,Snorkel的年化收入从约2000万美元增长至3.75亿美元。客户购买的也不再是一支外包标注团队,而是一套能够持续生产训练数据、评测模型并支持模型迭代的数据基础设施。
目前,Snorkel的客户覆盖前沿AI实验室、大型云厂商、企业以及美国政府机构,其中编程数据是需求最集中的领域之一。
与此同时,公司正在向更复杂的数据产品延伸:强化学习环境。
这也是Agent时代对数据提出的新要求。
对于传统聊天模型,人类可以通过“问题—答案”的形式判断模型表现。但当模型开始自主执行任务,仅仅提供正确答案已经不够。
以代码Agent为例,它需要进入代码库、定位Bug、修改代码、运行测试,并根据测试结果决定下一步操作。训练这样的Agent,需要一个能够模拟真实工作流程的环境:Agent可以在其中执行操作,系统记录状态变化,并最终根据可验证的结果判断任务是否完成。
Snorkel正在提供的,正是这样的环境。例如,公司曾与保险行业专家合作搭建模拟保险承保环境:Agent获得企业资料、数据库和承保规则后,需要按照真实业务流程完成承保判断,再由系统依据专家制定的标准评估结果。
03 AI数据生意,正在分成几条路线
Snorkel并不是唯一一家押注AI数据的公司。过去两年,Scale AI、Mercor等公司都在快速扩大这门生意。
Scale AI最早从数据标注切入,客户把模型训练、评测等任务交给平台,再由Scale组织标注员、领域专家和软件系统完成数据生产。随着大模型进入后训练阶段,其业务已经扩展到数据采集、生成数据、RLHF、模型评测和安全测试等环节。
2025年6月,Meta以143亿美元投资Scale AI约49%的股份,使其投后估值达到约290亿美元。
Mercor更接近一个面向AI公司的专家网络:平台聚集程序员、医生、律师、研究人员等专业人士,再将他们匹配给AI公司,完成模型训练、评测和人工反馈。
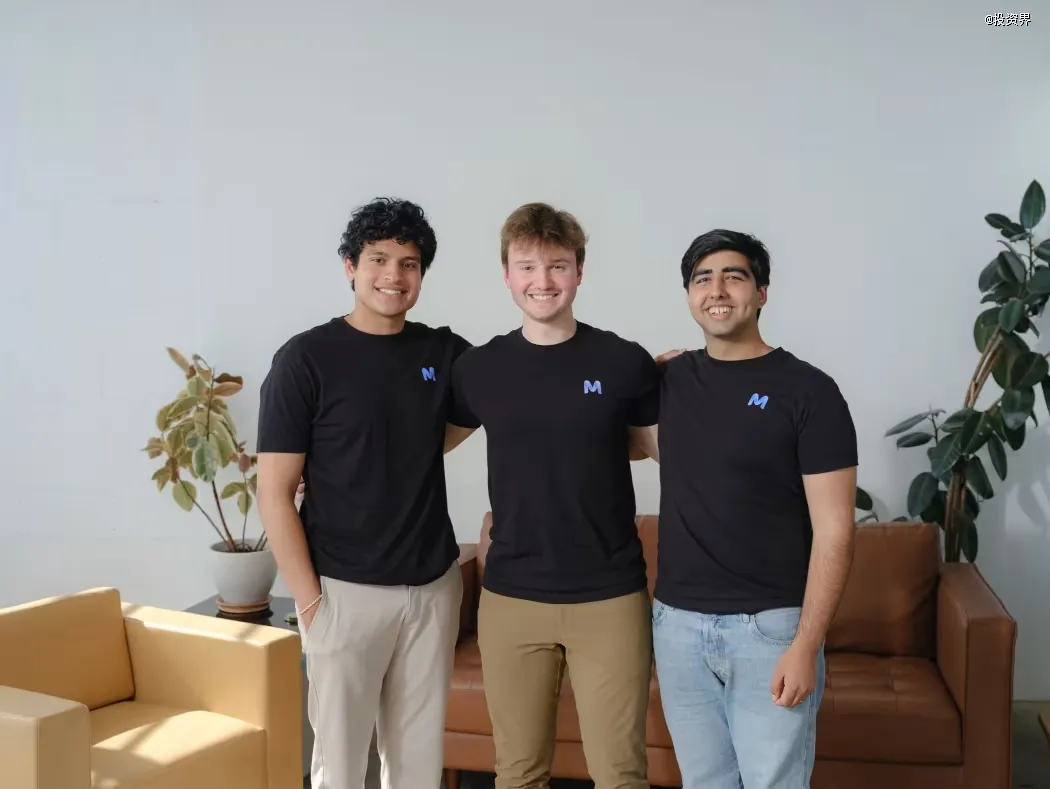
Mercor创始人,从左至右:首席技术官Adarsh Hiremath、首席执行官Brendan Foody和首席运营官Surya Midha
Snorkel则将软件、专家网络和AI模型结合起来,让专家负责定义任务、设计场景和制定评价标准,再由AI承担大规模的数据生成、筛选和质量控制,最终向客户交付训练数据、评测数据和强化学习环境。
三家公司背后的商业模式也因此出现了差异:Scale AI强调规模,Mercor强调专家,Snorkel则试图把专家知识产品化。
随着AI训练从数据标注走向后训练和Agent开发,三家公司的业务边界也在逐渐重合。Scale AI从数据标注进入模型评测和RLHF,Mercor从专家网络延伸至Benchmark和强化学习环境,Snorkel则从数据生产软件走向成品数据和Agent训练环境。
这种分化在国内也正在发生,只是国内公司的路线更加分散。
一部分公司仍然在传统AI数据服务的基础上向大模型训练延伸。海天瑞声、数据堂、标贝科技等公司,已经从数据采集、标注进一步进入大模型训练数据、模型评测和高质量数据集等业务。这类公司的核心能力,仍然是把数据采集、加工、标注和交付做得更大、更快、更稳定,商业模式与早期的Scale AI更为接近。
另一部分公司则开始进入Physical AI的数据采集。
手亿通过腕带、头戴设备等硬件,把人的真实操作转化为机器人训练数据;星忆进一步向高自由度、多模态物理交互数据延伸;真觉万象则围绕可穿戴采集、力学解码和数据对齐等环节搭建Physical AI数据基础设施。
它们解决的是另一个问题,机器学习所需要的真实世界数据,究竟从哪里来?
这也让AI数据产业开始出现越来越清晰的分层:有人负责采集数据,有人负责加工和标注,有人负责把专家知识转化成训练数据,还有人开始直接设计AI训练和试错的环境。
从这个角度看,国内外AI数据公司的竞争,正在从“谁能生产更多数据”,走向谁能够控制数据生产链条中的更高价值环节。
对Snorkel而言,它真正押注的,也不再是AI公司还需要多少人来标数据,而是专家知识能否被软件和AI规模化,最终变成一种可以持续交付的数据基础设施。
如果这条路径成立,AI数据公司的生意就会从“卖人力”进一步走向“卖知识、卖数据,以及生产这些数据的系统”。
而这场竞争的下一站,可能已经不再是谁能生产更多数据,而是谁能为AI生产出更好的任务和更真实的训练环境。
本文为创业邦原创,未经授权不得转载,否则创业邦将保留向其追究法律责任的权利。如需转载或有任何疑问,请联系editor@cyzone.cn。