整理丨狮子侠
编辑丨小龙、子钺
2026年10月6日,OpenAI发布《Sharing AI progress in mathematics》,一口气将内部前沿模型生成的722份数学研究稿件、共计372组相关成果挂上了官方博客和GitHub。
这些数字足以令人震动,而它所展现出的效率更是惊人。按OpenAI的算力折算口径,每项成果平均消耗的计算资源,约相当于ChatGPT Pro思考三小时。随稿件公开的,还有许多证明的Lean形式化版本(一种用于机器验证数学证明的交互式定理证明器),以及10份模型推理摘要。不过,产生这些成果的模型,当时并未同步开放。
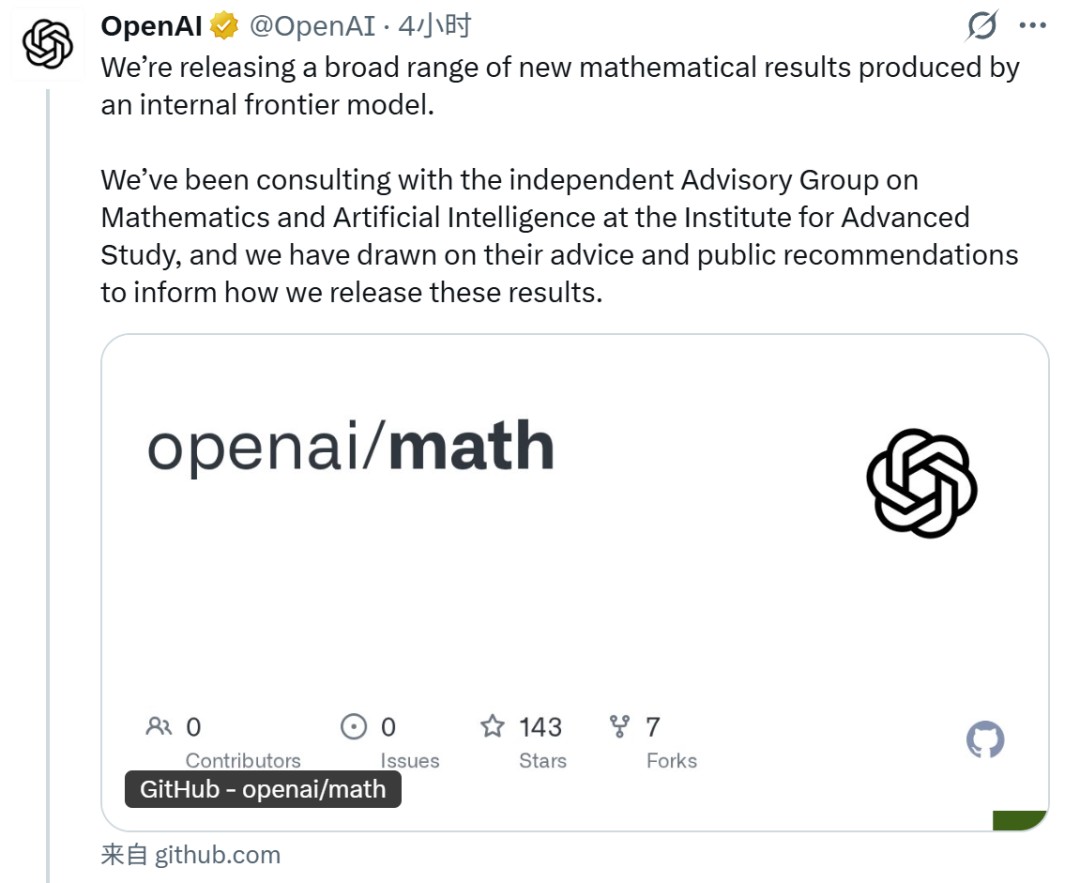 OpenAI一次性释放722份数学成果论文,图源:OpenAI社交媒体账号
这对数学界无疑是一颗重磅炸弹。就连原本支持使用AI辅助数学研究的菲尔兹奖得主陶哲轩都转载了一段人类数学协会(Association for Human Mathematics)的宣言(该组织内所有成员均宣言自己不会发表完全由AI生成的论文,不过陶哲轩不在其中)。
宣言称“一次性发布700多个文件,不是学术的展示,而是力量的展示”,甚至呼吁数学家停止与OpenAI合作。
两天后,在加州理工学院的“Math 2.0”演讲中,陶哲轩对此次事件进行解释。他说,自己关心的不只是AI自动解决开放问题的能力,而是这些工具最终把数学带向哪里:是支撑数学共同体、让理解继续服务现实世界,还是把解题数量当成唯一目标。
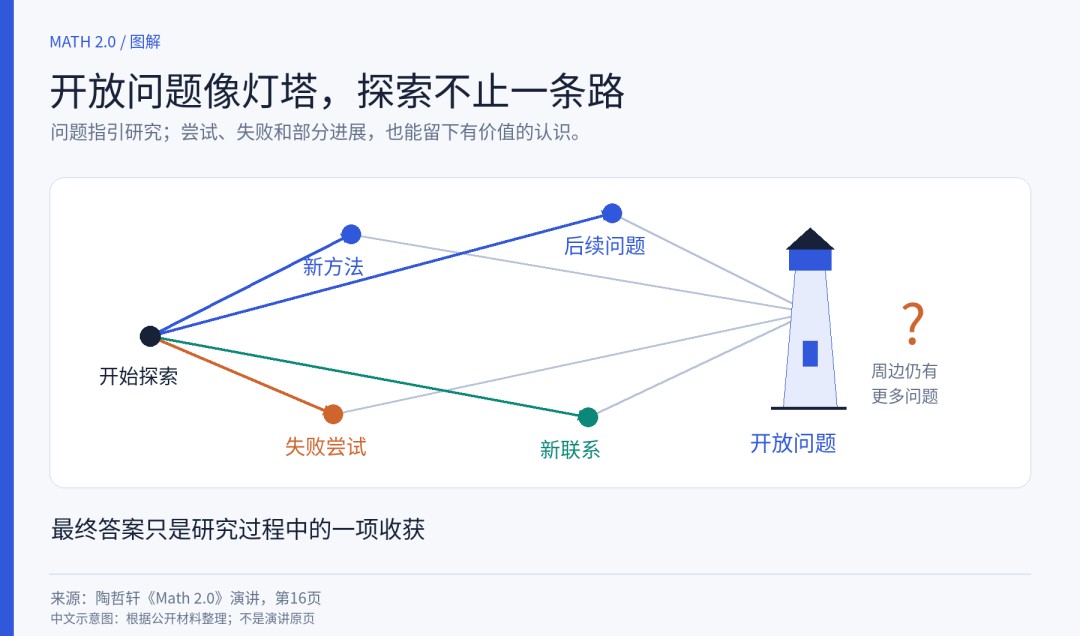
对于数学研究的目标到底是什么这个问题,陶哲轩给出的比喻很形象:开放问题像灯塔。它们指引人们探索周边的数学世界,而抵达灯塔,并不等于完成了探索。
不过,并非所有人都被这种末日情绪所裹挟。2026年菲尔兹奖得主、芝加哥大学教授邓煜态度出奇地轻松。他甚至半开玩笑地放话,要是以后AI真能把所有数学题都解完了,自己大不了就“回家写小说去”。
在邓煜看来,AI固然能做短篇幅、局部的逻辑推导,甚至能在人类给定的清晰路线图下充当高效的“代工机器”,但数学真正的核心永远是“理解”。当算力堆叠出成百上千个未经真正消化的证明时,数学界面临的真正考验,是如何在狂热的“刷榜”浪潮中守住那条关乎底层逻辑与人类理性的边界。
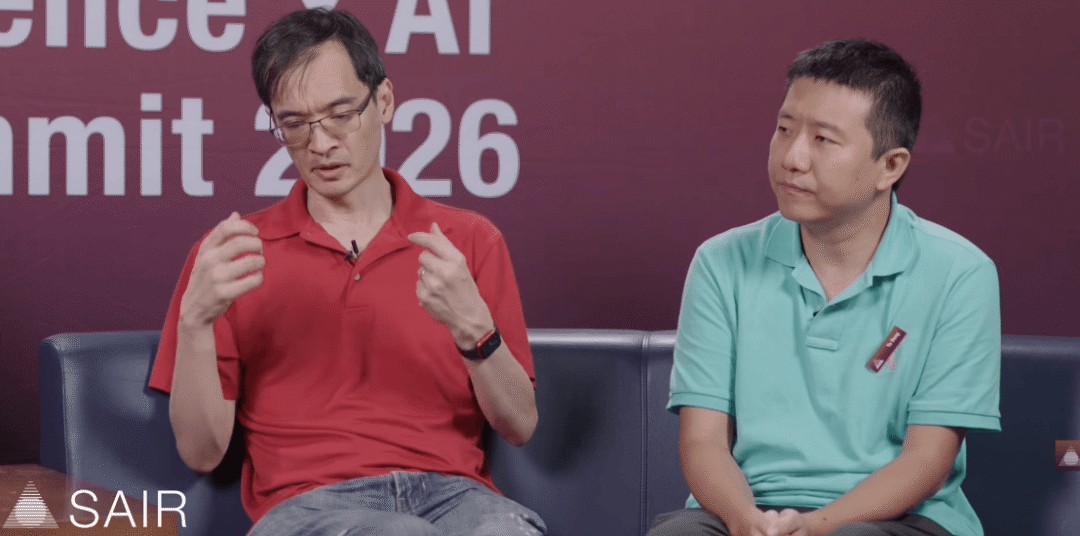
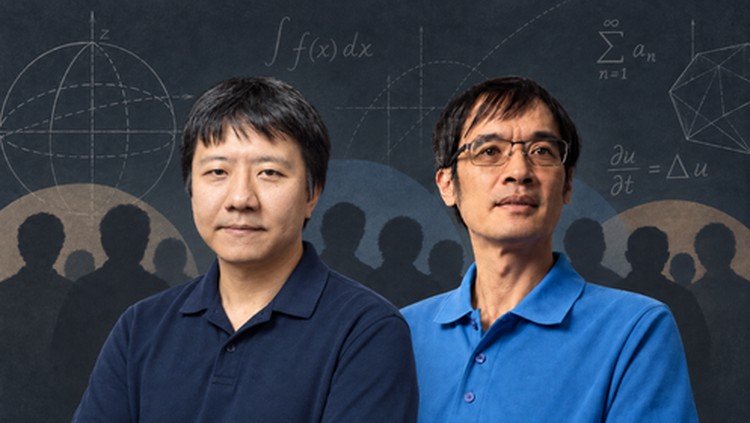
10月20日,陶哲轩和邓煜坐到一起,围绕AI对数学研究的深刻影响,以及开源数学模型的未来展开了一场深入对谈。
以下是创业邦对本场对话的翻译精编。
AI时代的慢科研,在追求速度之外守住数学的本质
主持人:最近,一家头部商业AI公司一口气发布了700多份数学证明,直接把互联网炸开了锅。很多人的反应是:“好吧,看来AI现在连数学家都要取代了。”但如果真去和数学界的人聊聊,你会发现,大家真正关心的并不是机器抢饭碗,而是学术诚信、成果究竟该归功于谁,还有数学这门学科最核心的东西。
今天,我们请到了邓煜和陶哲轩,先请两位向听众介绍一下自己。
邓煜:大家好,我是邓煜,现在是芝加哥大学的数学教授,主要研究偏微分方程、概率论这些领域。
陶哲轩:我是陶哲轩,在加州大学洛杉矶分校担任数学教授,主要研究分析、数论和组合数学,最近也在参与一些和AI有关的工作,关注整个数学领域未来会怎么发展。
主持人:谢谢两位。在聊其他问题之前,我想先问问你们对AI的态度。外界似乎觉得,很多数学家是反对AI的。但我希望听到两位更具体、更细致的看法:你们觉得AI可以怎样用于数学研究?现在又已经有哪些用法?
邓煜:我觉得使用AI是好事,也是未来的方向。它能大大拓展数学和研究的边界,关键是要用对方法。我今天上午做报告时也提到了这一点。这主要是学术规范和伦理层面的问题。
如果单从技术上看,最近这些证明本身确实很精彩,里面有一些非常漂亮的新想法。先不谈公司的做法,只看证明,我觉得我们现在其实处在一个很好的阶段:AI向人学习,吸收人的思路,再产生自己的新想法;而这些新想法,我们也能理解,还可以在它们的基础上继续发展出新的思路。人和AI一起进步,这正是我希望看到的。
陶哲轩:现在大家好像总想把人分成两派:支持这个,反对那个。但技术从来没有这么简单。你能直接问一个人:“你支持汽车,还是反对汽车?”“你支持互联网,还是反对互联网?”事情显然不能这么一分为二。每种技术都有好处,也有坏处。你可以只盯着好处,或者只盯着坏处,但实际情况总要复杂得多,AI当然也一样。
AI让我们能做更多事,很多过去很难完成的任务,现在都能自动化了。但与此同时,它也在挤掉一些速度更慢、却同样很有价值的做事方式。理想情况下,我们当然希望两边的好处都能保留下来。就像开车比走路快,但你不会希望所有原本可以走路的场合,都改成开车。有时你就是想散散步,也可能是出于安全、环保,或者其他考虑。
所以我们得找到一个合适的平衡:既用上这些强大的工具,把事情做得更快,也保留慢慢做科学、做数学的好处,比如逐步加深理解、建立学术共同体,让人类自己始终掌握对一门学科的理解。毕竟,速度并不是我们唯一想追求的东西。
邓煜:对。我觉得有一种情况就特别适合用AI。比如,你面对一个问题,已经有了解题路线,具体分几步也想清楚了,只是实际推导太复杂,真要把细节全部做出来,会花很多时间。也就是说,你知道大致该怎么做,也知道这条路为什么能走通。这时把具体工作交给AI,就是很好的用法。它帮你省下时间和精力,你就能把注意力放在更根本的问题上。
两条边界的断裂:当证明被写出来,却没有人真正理解
主持人:很有道理,尤其是你们说的,我们应该根据具体情况不断调整,而不是简单地全盘支持或全盘反对,这一点很重要。说到这里,也就回到了最近这件事。很多人觉得,这是那家商业巨头搞的一场宣传秀。可发布之后,他们又因为基本的符号错误,不得不撤回了3份预印本。大家还发现,文字表述和Lean代码之间存在很大的脱节。
一家大型科技公司以这么快的速度,把这些还没打磨好的证明一股脑扔出来,确实会造成学术文献污染。那我们该怎么避免其他人跟着这么做?又该怎么避免研究人员浪费自己的时间,免费替他们找错、修错?
陶哲轩:我觉得,我们需要调整激励机制和价值评价体系。这些科技公司之所以会大张旗鼓地宣布自己解决了哪些问题,部分原因在于,我们数学界自己也一直很看重“解决问题”这件事。因为过去,一个人解决了某个问题,通常也就意味着他对这个问题理解得很深,能把它讲清楚,能在这项工作的基础上提出新问题,也能培养学生。
这些事情原本是连在一起的。我们给解决问题的人颁奖,真正奖励的其实是背后这一整套学术工作,只不过“解决了什么问题”最容易拿来当衡量标准。但现在,OpenAI和其他一些公司几乎是在训练模型的过程中,顺带把这些问题解决了。
对它们来说,这些问题只是训练和评估更通用模型的一套好用的测试题。于是,这些证明就成了某种副产品,打个比方,像是“有毒废料”。然后它们得想办法处理,或者最后变成我们来处理。
所以,我们必须更明确地表达:我们不是为了把问题解决掉而解决问题,我们要的是更全面的理解,以及从中获得的新认识。
理想情况下,产出这些证明的公司应该和我们合作,一起把证明讲清楚。甚至在项目开始之前,就应该请数学家参与,而不是事后才来收拾残局。这方面可以建立一些值得大家遵循的做法。
但现实一点说,我觉得这种事还是会不断发生。到某个时候,我们就得明确说:如果你只是解决了问题,却没有带来其他这些有价值的东西,那它还不能成为我们认可的数学文献的一部分。我们会慢慢去研究这些证明。
比如,OpenAI这次发布的内容里,有十来个问题是我关心的,我以后也会去读。但现在,这确实不是我的优先事项。它们目前的讲解方式,还没有让我产生特别想深入研究的兴趣。最终我们会去看,只不过,如果他们一开始就和我们合作,这个过程本来可以快得多.
邓煜:我一直很认同“加深理解”这个想法。我们为什么做数学?不同的人可能有不同的答案。对我来说,就是为了理解这个世界。这里的世界,既包括现实世界,也包括抽象的数学世界。
那什么叫理解呢?其实可以想象有两条边界。第一条,是在所有数学问题里面,把已经有证明的问题划出来。第二条,是在这些已经有证明的问题里面,再把我们真正理解了证明的问题划出来。
以前,第二条边界基本不需要单独考虑,因为既然有人做出了证明,就意味着至少有人能理解它。但现在,如果只有AI给出了证明,人还没有理解,那么第二条边界就真正显现出来了。所以,我觉得我们一直以来追求的价值,其实是一致的,只是情况变了。表面上看,好像我们需要改变评价标准,但在我看来,我们做数学时坚持的,始终是同样的东西。
AI暴力解题,切断科学数千年的思想传承链
主持人:这也涉及成果归属和公平的问题。看了菲尔兹奖得主们的那封公开信,我想问:一家商业公司用这种方式炫耀算力的时候,它究竟把谁的功劳算到了自己头上?某种意义上,这不就是在提取和利用别人的研究成果吗?它们的数据来自其他人的研究,来自其他人的论文。那我们到底该怎么追溯这些贡献?
陶哲轩:几百年来,学术界一直遵循开放科学的原则,把科学文献看作大家共享的资源。我们发表论文,当然,有些期刊是要付费才能看的,这方面确实存在值得讨论的问题。不过先把这个放在一边,科学文献本来就应该向所有人开放,大家也本来就应该利用前人的研究。当然,要做好引用,让人能追溯一个想法是从哪里来的。科学就是这样向前发展的。
现在,我们有了一种技术,能吸收科学家和数学家上千年来积累的文献,再通过一个不太透明的过程,把它们转化成答案。有时候,AI会告诉你:“我用了这篇论文里的某个结果。”但有时候,它没法一路追溯回去,或者干脆没有展示这些想法的来源。这样一来,思想传承的链条就开始断了,真的是字面意义上的“思维链”断了。
这很可惜,因为理解这些来龙去脉,本来就是我们解决问题时要学到的一部分:这项工作受到了哪些研究的启发?哪些关键想法其实已经在已有文献里初露端倪?也许这只是暂时的问题,未来的AI可能会更擅长追溯来源。但现在的技术在这方面确实很差。
而且,我觉得科技公司有动力淡化这一点,因为它们希望大家相信,这些AI仿佛凭空就解决了问题,没有借助任何前人的成果。但实际上,它们和人类科学家一样,都是建立在人类几千年的努力之上的。只不过,它们有时会承认前人的贡献,有时不会。这一点必须改进。
邓煜:对,这是整体上的情况。还有更具体的例子:有人直接把别人之前提出的思路输入ChatGPT,然后就生成了一份证明。所以,我觉得最终的目标,是要有办法真正追溯这些想法的来源。
就目前来说,如果能看到AI的思考过程,至少还能大致知道,它是怎么走到这一步的,参考了哪些东西。但如果连这些都不公开,那就太离谱了。如果我们想做出不依赖这些大公司的工具,追溯想法的来源就应该是我们努力实现的目标之一。
为什么要构建“开放数学模型”?
主持人:从这件事的发展来看,产业界和科学界之间似乎确实有些脱节,尤其是双方看待和处理这些问题的方式不一样。对公司来说,这好像已经成了一次秀实力的营销活动。只不过,在一些人看来,这场秀可能翻车得相当惨。但这也提醒我们,需要就接下来能做什么达成一些共识。
Terence(陶哲轩),你是SAIR基金会的主席,你们最近推出了开放数学模型项目。你最初牵头做这件事,是出于什么样的想法?为什么你觉得,开源模型能给数学家带来一些闭源模型做不到的帮助?
陶哲轩:当初成立SAIR时,我的一个想法就是,为数学界提供由数学界自己开发的工具,让这些工具符合我们的价值观,也服务于我们自己的目标。大型科技公司确实给了我们一些有用的工具。我自己经常使用它们的专有模型,很多同事也是。有些功能确实非常符合我们的需求。比如文献检索,现在已经做得很强,也很实用。我们查文献的能力变强,并不会因此削弱我们对研究内容的理解。
但正如刚才说的,有些时候,它们生成了证明,却没有带来相应的理解,引用有时也不完整,这就打断了文献之间的传承关系。所以,我们一直希望能独立于大型科技公司,开发自己的工具,而且让数学界充分参与。
我们讨论过很多方案,后来觉得,做一个数学开源模型,再配上一套方便使用的框架,应该会很有帮助。这样,大家就不用自己部署,也不用自己买GPU。我们原本有一个长期推进的计划,但过去几个月发生了这些事之后,很多数学家突然都很希望找到别的方式来使用AI,而不只是依赖那些开发前沿模型的科技公司。
所以,我们加快了Open Math OS的发布。这里也澄清一下:我们现在还没有自己的新模型,初期用的是现有的开源模型。但至少围绕模型的操作系统已经搭起来了。我们希望,它现在就能派上用场,把模型和各种工具整合起来,让大家可以协作。
我们也在组织不同团队,邀请很多合作伙伴参与,有的提供想法,有的提供数据,有的负责训练,还有的提供算力。希望再过几个月,我们就能在现有开源模型的基础上,推出自己的模型。我很期待看到这个社区会怎么发展,以及接下来几个月我们能拿出什么成果。
主持人:那邓煜呢?是什么让你决定和Terence一起参与这个项目?它的哪些地方特别打动你,让你觉得有启发,或者直觉上就觉得这件事值得做?
邓煜:原因其实很简单。刚才也说了,科学一直是开放的,那么用于科学研究的AI也应该是开放的,不应该建立在闭源AI工具之上。我最早是在国际数学家大会期间,和SAIR的人取得联系的。当时我们聊了一些事情,也讨论过一些具体项目。
后来,9月份发生了那件和研究笔记有关的事,建立开放数学模型就变得更紧迫了。与此同时,我也在和南加州大学的朋友联系,发现他们做的事情和我们完全一样,连计划都很相似。
现在,世界各地有不少团队都开始往这个方向做。我觉得这已经是一种趋势:整个学术界,至少数学界,会尽力让数学和科学继续保持开放。当然,具体落实还有很多工作要做,但这就是我们的基本想法。
AI越强,人越要会问对问题
主持人:我觉得,有数学家参与和支持也特别重要。这不能只是AI领域单方面的努力,也不能只靠数学家,双方的经验和想法都要结合起来。
那换个角度,有了这些模型之后,你们觉得人的创造力里,哪些部分会变得最重要?AI应该怎样和人合作,才能真正帮到人,而不是取代人?
陶哲轩:关键是让人的能力变强。我们要想办法,把工具交到科学家、数学家或者其他人手里,让他们在使用工具的过程中,自己也变得更聪明,对问题的理解更深,而不是为了从AI那里得到一个答案,反过来牺牲自己的能力。
这和其他技术一样,还是拿汽车打比方:如果你去哪儿都开车,最后可能连怎么走路都快忘了,或者至少身体会越来越缺乏锻炼。但这不意味着你就应该彻底放弃汽车,而是要有意识地想清楚了再用。
我觉得我们可以相信大家,尤其是年轻一代。现在,数学领域很多过去熟悉的规则都在变,大家可能会焦虑,甚至感到绝望。但只要他们弄清楚现在能做什么,尤其是当这些工具真正掌握在他们手里时,他们就会迎接挑战,做出一些非常有创意的新东西,让我们忍不住说:“哇,这我怎么就没想到?太棒了!”我对年轻人很有信心。只要给他们合适的工具,他们一定能做出令人惊叹的事情。
邓煜:首先,AI就是一种工具,它本身并没有天然的好坏之分。真正重要的是围绕它建立的整套机制。比如开放性,我觉得这就是一个关键条件:AI工具要对学术界的健康发展有帮助,长期给大家带来好处,就需要保持开放。
然后才是在AI时代,人的哪些能力最重要。就像刚才说的,将来肯定还会出现很多新的用法、新的想法。我先举几个例子。一个是提问的能力,尤其是提出恰当问题的能力。AI解决了一个问题之后,通常又会直接引出几个更多、也很有意思的新问题,你就可以接着去探索。
我在报告最后的幻灯片里画过一张图,想表达的就是:你可以先沿着AI走过的路线前进,然后自己转向新的方向,展开新的探索。这就要求你能问对问题,也要有整体规划。我们已经看到一些例子:如果人对一个问题有很好的理解,最好连证明的路线都已经想清楚了,知道“只要这样做,再那样做,这个问题就能解决”,那么AI也许就能把它完成。
我的合作者比约恩·布林格曼昨天刚给我看了一个例子,是一个具体的随机偏微分方程问题。大家已经大致知道该怎么做,他就用GPT Astra试了一下,结果一两天就解决了。但这还是要求你先对问题有足够深入的理解,脑子里有一个证明计划。当然,还有提出全新想法的能力。总的来说,就是那些让你能引导AI,也能不依赖AI,独立开展研究的能力。
本文为创业邦原创,未经授权不得转载,否则创业邦将保留向其追究法律责任的权利。如需转载或有任何疑问,请联系editor@cyzone.cn。