编者按:本文来自微信公众号“量子位”,作者:闻乐 ,创业邦经授权转载
MiMo-V2.6刚发布,罗福莉就开始剧透MiMo-V3了。
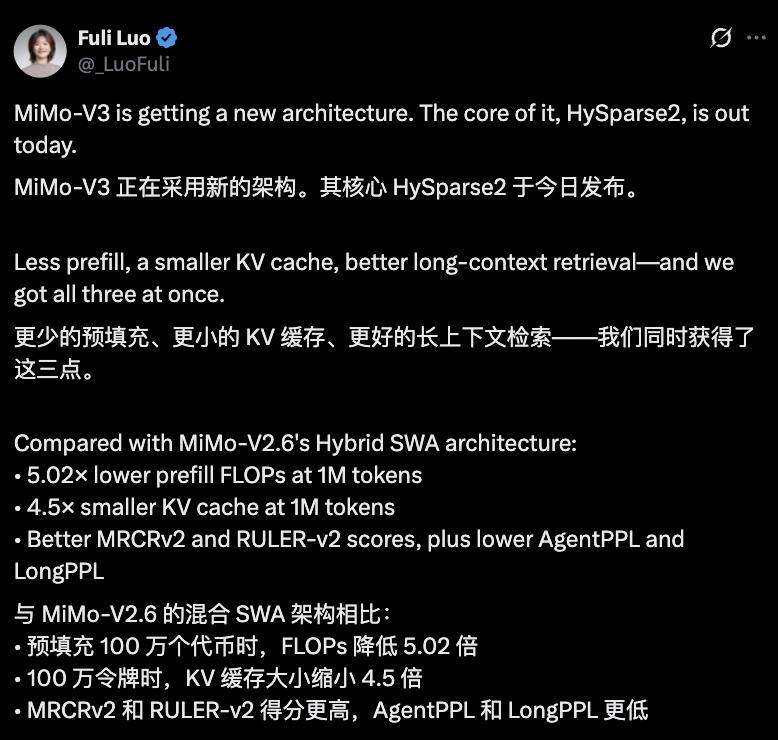
MiMo-V3将采用新架构,核心是HySparse2,是Agent执行长任务时越来越重的输入处理。
Agent生成一次工具调用可能只需几十个token,搜索结果、网页、代码和执行日志却能一口气回来几万字。
模型读完继续操作,每一轮结果都要进入上下文;
轮次增加后,模型既要处理新输入,也要保留足够的历史信息供后续检索。
所以团队想让模型少花力气处理输入、少占内存保存历史,同时还能从很长的记录里找准线索。
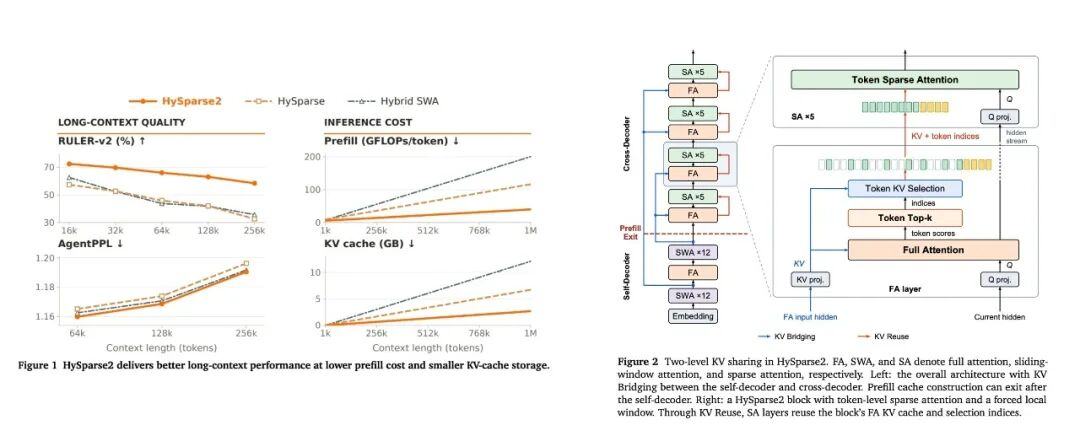
在80B总参数、每个token约激活3B参数的MoE模型配置下,到了100万token上下文,HySparse2的预填充计算量约为Hybrid SWA的1/5.02;
KV Cache从12.09GB降至2.69GB,约缩小4.5倍。
省下来的不只是资源,在多轮检索测试中,它找历史信息的成绩也更好。
预填充只走前半程
首先说说Agent为什么会被“读材料”拖住。
比如让模型修一个代码问题,它会先查文件,再运行程序;程序返回报错,它会继续查相关代码,修改后重新测试。
Agent每一步生成的指令可能很短,但工具返回的文件、日志却很长。
这些内容进入上下文后,模型得先处理输入,建立后续生成要用的KV Cache,才能决定下一步怎么做。
这个处理阶段叫预填充(Prefill)。
在多轮Agent任务中,工具返回的内容通常远长于Agent发出的指令,因此预填充成本会随着任务推进持续累积。
小米此前的HySparse已经用上稀疏注意力,让少量全注意力层查看更完整的历史,再由后续的稀疏层复用它选出的内容和缓存。
比起让每一层都从头看遍长上下文,这能省下不少注意力计算。
但长输入在预填充阶段仍需经过所有模型层。
HySparse2进一步调整了模型的层间依赖,让预填充可以在中途结束。
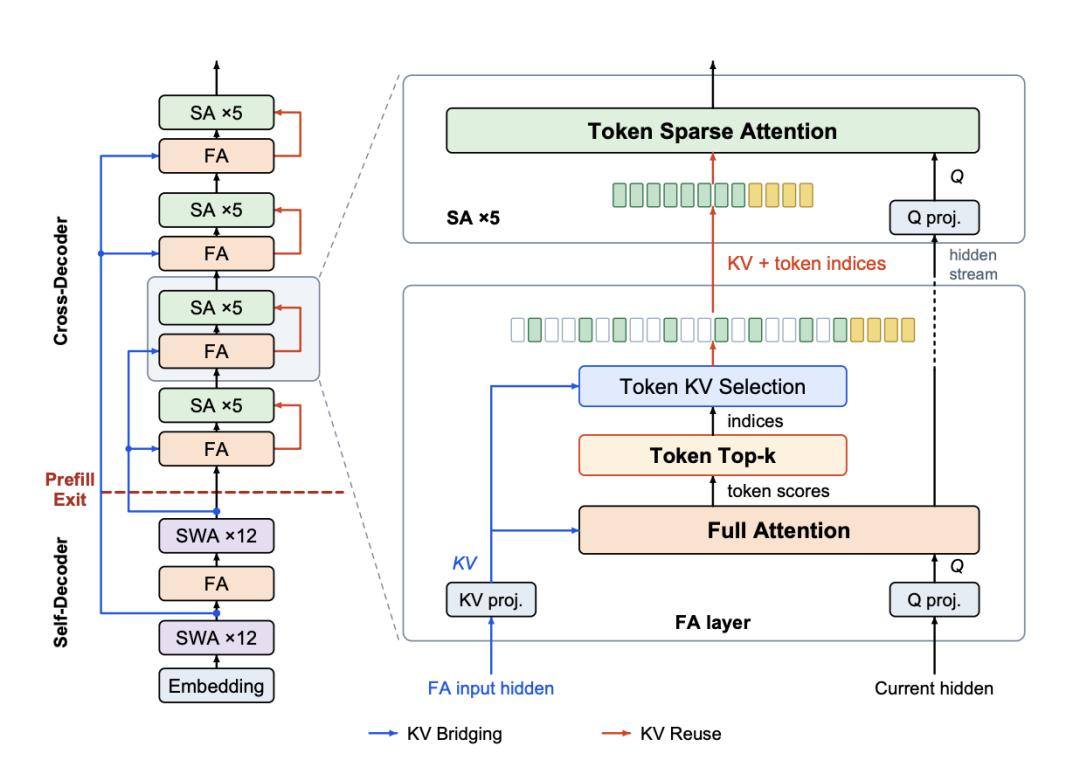
具体来说,模型被划分为前后两段,前段是self-decoder,后段是cross-decoder。
前半段结合全注意力与滑动窗口注意力,后半段结合全注意力与稀疏注意力。
两段之间的KV Bridging只连接全注意力层:
后半段全注意力层从前半段对应层的隐藏状态生成K和V,同时保留各自独立的投影参数。
后半段内部的KV Reuse则让稀疏层复用同一混合模块中全注意力层的KV Cache和token选择结果。
有了这座桥,一批新材料进来时,预填充走完前段,就能停下,不必再让整段输入逐层跑完后段。
到了模型继续生成内容的时候,后段仍正常参与计算。
论文标题所说的两级KV共享,指的就是这两处设计。
仅有跨层共享还不够。
上一代设计中,稀疏层另设一条滑动窗口注意力分支;这条分支的缓存依赖后半段逐层计算得到的隐藏状态。
如果保留它,长输入仍需进入后半段构建缓存,预填充就无法完全提前退出。
所以HySparse2拿掉了这条独立分支,改为强制将最近的token纳入稀疏选择。
局部信息仍被保留,但与远处选出的token使用同一套共享KV Cache。
于是,后半段需要的缓存都可以从前半段的状态构建,长输入的预填充走完self-decoder即可结束;模型随后生成token时,cross-decoder仍正常参与计算。
论文展示的模型共有49层,采用预填充与生成分开部署的方案时,预填充节点只需放前25层和相关投影模块,所需模型内存接近减半;
在这套配置里,预填充阶段执行全注意力的也只有一层。
检索精确到token
减少输入计算之后,长历史中的信息能否被准确找回,取决于稀疏层如何选择内容。
上一代HySparse按“块”挑内容。
一个64-token的块里即使只有少量内容相关,整块也会占用选择预算。
论文指出这种方式在早期预训练评估中没有表现出明显劣势,但面对跨越多轮工具调用的Agent任务,检索精度不足的问题变得突出。
所以HySparse2把选择粒度改到了单个token。
论文中的配置是挑选1024个全局token,再强制保留最近128个token。
这样既能去较早的历史里找分散的线索,也不会漏掉眼前刚收到的工具结果。后续稀疏层继续复用这些选中位置及其缓存。
对需要跨越多轮工具调用找证据的Agent来说,有限的注意力名额究竟给谁,会直接影响它能否把前面的线索接到当前任务上。
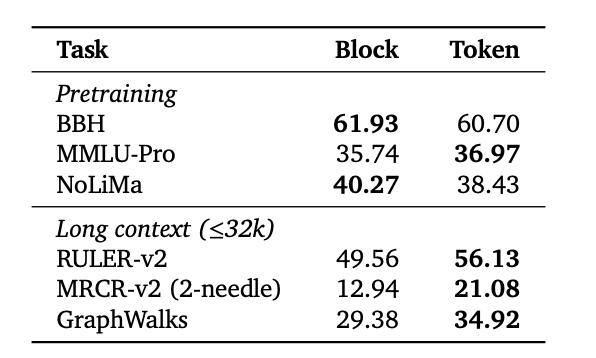
消融实验里,在保持骨干结构和注意力预算一致,仅比较按块选与按token选的情况下,在32k及以下的长上下文测试中,按token选择让RULER-v2提高6.57个百分点,双线索MRCR-v2提高8.14个百分点,GraphWalks提高5.55个百分点。
当然,HySparse2也没有完全撤掉全注意力。
团队认为,少量全注意力层既有助于维持模型能力,也能用完整的注意力分数,帮后面的稀疏层选出值得看的token,就无须再单独训练一个检索模块。
架构改了这么多,最终还得看模型能不能把事做对。
小米团队用相同的数据和训练安排,对比了HySparse2、HySparse,以及Hybrid SWA三种注意力设计。
预训练后的普通知识、推理和代码项目中,HySparse2的成绩有升有降,整体与对照模型大致可比;优势主要出现在长上下文能力上。
加入Agent数据、再经过后续训练后,差距变得更明显。
HySparse2在论文评估的各个上下文长度上,MRCR-v2和RULER-v2检索成绩均领先两个对照架构,Agent轨迹与长距离依赖相关的困惑度也更低。
到了256k上下文,HySparse2在RULER-v2拿到58.45,上一代HySparse是32.61,Hybrid SWA是35.74。
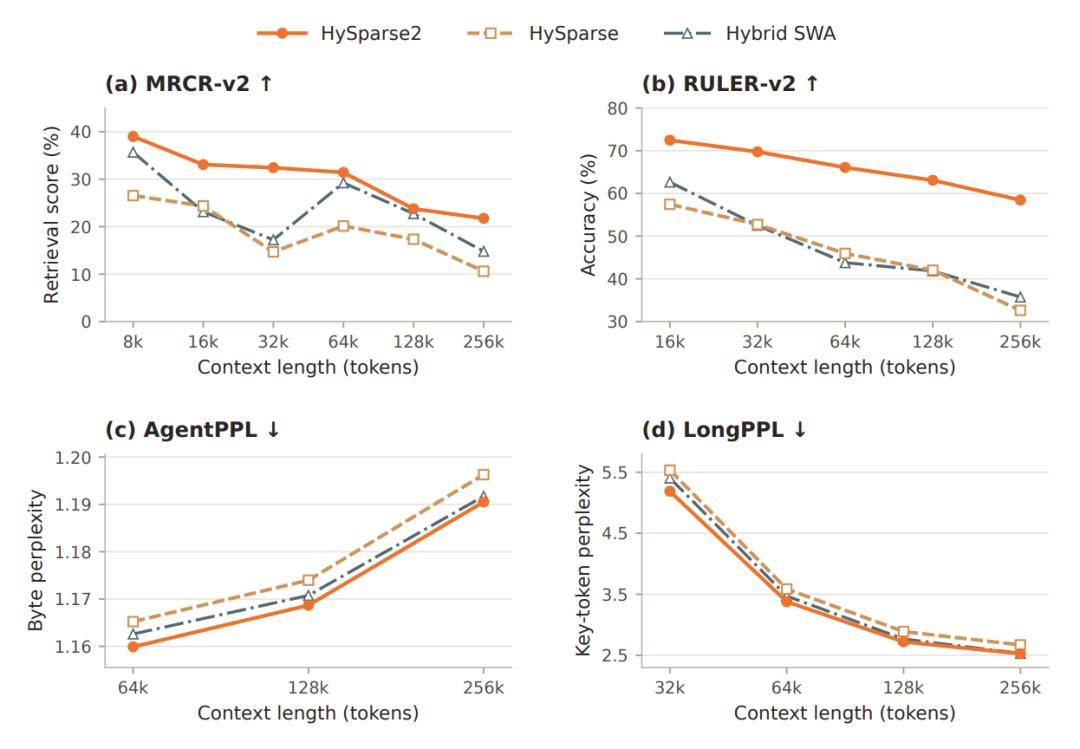
按测试长度取平均,它的MRCR-v2和RULER-v2成绩比HySparse分别高11.30和19.81个百分点。
成本上,在100万token处,论文分析得出的预填充计算量,HySparse2比HySparse降低约2.92倍,比Hybrid SWA降低约5.02倍。
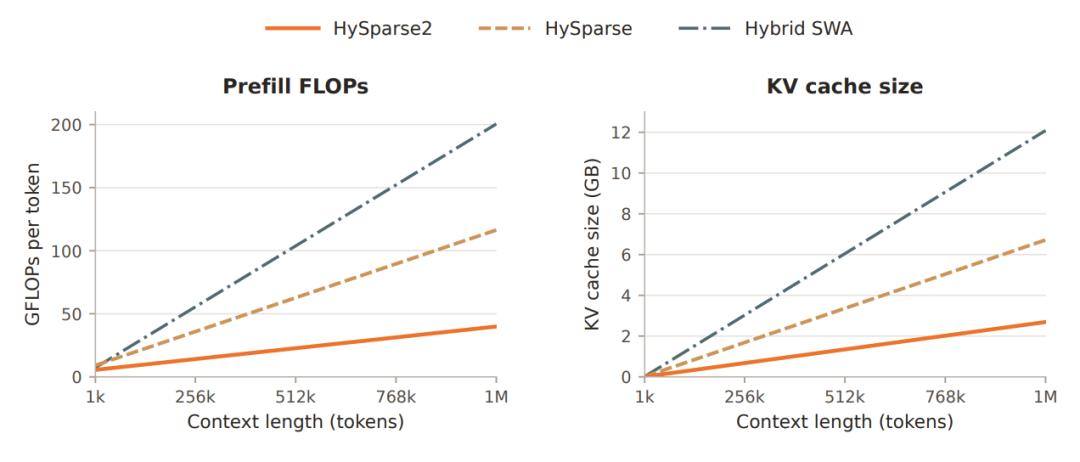
采用FP8缓存时,三者的KV Cache占用分别为2.69GB、6.72GB和12.09GB。
但5.02倍比较的是预填充计算量,不是实际响应速度;论文的长上下文能力测试评估到256k,100万token对应的是计算量与缓存分析。
MiMo-V3尚未发布,实际产品里的延迟与任务表现,还要等模型落地后再看。
不过,HySparse2的取向已经很清楚——
Agent执行任务时,工具会不断送回大量新内容,历史里的关键线索又不能丢。
MiMo-V3能把论文里的改进带进多少实际任务,将是接下来更值得关注的结果。
参考链接:https://x.com/_LuoFuli/status/2102766365190901957?s=20
论文地址:https://arxiv.org/pdf/2609.26368
本文为专栏作者授权创业邦发表,版权归原作者所有。文章系作者个人观点,不代表创业邦立场,转载请联系原作者。如有任何疑问,请联系editor@cyzone.cn。